
DTBot 是2026年最新的,一款运行在本地的支持千万级 AI 数据处理与分析Agent。
不同于市面上多数 Agent 直接让 AI 生成臃肿 Python 脚本的传统做法,DTBot 依托 AI 大脑,首创了 SQL + Python 融合架构:直接让 SQL 支持 Python 流程编排(赋予 SQL 原生拥有 if 条件分支与 for 循环批处理能力)。既发挥了底层 SQL 处理千万级数据的极致计算性能,又兼具 Python 的灵活流程调度。在确保核心数据本地处理不出机的前提下,让用户仅凭自然语言,即可轻松搞定千万级表格的清洗规整、跨表核对、深度统计与分析看板生成。
架构创新:为什么比纯 Python 脚本 Agent 更强大?
市面上常见的代码解释器或数据分析 Agent(如让 AI 编写 Pandas 脚本在沙箱执行),在面对企业真实数据时普遍面临三大软肋:数据量大极易内存溢出、生成代码臃肿耗费巨量 Token、容错低且频繁报错。
DTBot 通过 SQL + Python 环境深度融合,彻底打破了上述瓶颈:
| 对比维度 | 市面传统 Agent (纯生成 Python / Pandas) | DTBot 融合架构 (SQL 计算能力 + Python 流程控制) |
|---|---|---|
| 数据承载力 | 内存膨胀严重,通常数十万行即陷入卡顿甚至崩溃 | 轻松承载千万量级,重型计算下推至高性能数据库底座,吞吐量提升数十倍 |
| 计算速度 | 解释型单核计算,面对大表的多表关联与聚合极慢 | 秒级极速响应,充分发挥列存与向量化查询的高并发性能 |
| Token 消耗 | 需逐行编写冗长的处理逻辑,极度消耗 Token 且耗时长 | 大幅节约 Token,指令高度抽象凝练,响应更快、成本更低、更少出错 |
| 流程灵活性 | 复杂多表调度逻辑复杂,难以标准化管理 | 脚本编排自由,完美支持多表循环遍历、条件判断分支与全自动流水线 |
DTBot 处理复杂任务案例
如下用户任务:
对“医院门急诊与住院就诊明细_样本”做分类型运营汇总:
1. 先清理所有文本字段的前后空格并剔除重复的就诊流水号;
2. 按“就诊类型”的取值把清洗后的表拆成若干子表(门诊、急诊、住院各一张);
3. 对上一步拆出的每一张子表,都按“挂号就诊科室”分组,统计该类型下每个科室的接诊人次和就诊总费用合计;
4. 把每个类型的分组结果纵向合并成一张总表,并保留“就诊类型”列以区分来源。
输出 “各就诊类型科室费用汇总表”。
DTBot生成的处理脚本如下:
t = ws.table("医院门急诊与住院就诊明细_样本")
# 1. 清理所有文本字段前后空格,并剔除重复的就诊流水号(保留首次出现)
cleaned = ops.sql(
    tables=[t],
    sql="""SELECT _id_inner, 就诊流水号, 患者卡号, 患者姓名, 身份证号, 联系电话, 性别, 年龄,
       TRIM(挂号就诊科室) AS 挂号就诊科室, 主治医师, 医生工号, TRIM(就诊类型) AS 就诊类型,
       就诊日期, 出院日期, 初步诊断编码, 复合诊断名称, 就诊总费用, 医保统筹支付,
       个人自付金额, 个人自费金额, 医保类型, 是否转入ICU, 住院天数, 就诊满意度
FROM "医院门急诊与住院就诊明细_样本"
WHERE 就诊流水号 IN (
    SELECT 就诊流水号 FROM "医院门急诊与住院就诊明细_样本"
    GROUP BY 就诊流水号 HAVING COUNT(*) = 1)
""",
    output_name="fish_tmp0_cleaned",
    rows_rel="subset",
    task="清理文本字段前后空格并剔除重复就诊流水号")
# 2. 按就诊类型拆成门诊、急诊、住院各一张子表
parts = ops.split_by_column(cleaned, columns=["就诊类型"], output_prefix="fish_tmp0_by_type")
# 3. 对每张子表按挂号就诊科室分组,统计接诊人次与就诊总费用合计
agg_tables = []
for p in parts.tables:
    g = ops.sql(
        tables=[p],
        sql="""SELECT 就诊类型, 挂号就诊科室,
       COUNT(*) AS 接诊人次,
       CAST(SUM(就诊总费用) AS DECIMAL(38,2)) AS 就诊总费用合计
FROM \"""" + p.name + """\"
GROUP BY 就诊类型, 挂号就诊科室""",
        output_name="fish_tmp0_agg_" + str(p.name),
        rows_rel="group",
        grain=["就诊类型", "挂号就诊科室"],
        task="按挂号就诊科室分组统计该就诊类型的接诊人次与就诊总费用合计"
    )
    agg_tables.append(g)
# 4. 纵向合并成一张总表,保留就诊类型列
ops.concat_rows(tables=agg_tables, output_name="各就诊类型科室费用汇总表")
这个看不懂没关系, 这个是将Python语法+SQL融合的一个自研平台。
任务完成后,总结,产物,执行过程,结果表数据实时可查,如下:
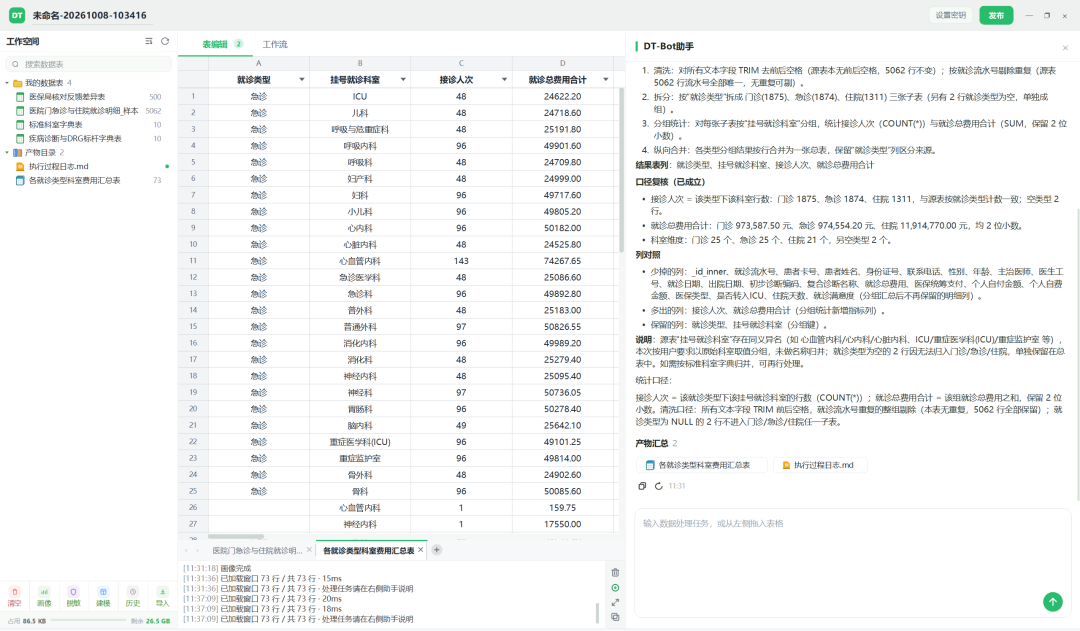
DTBot核心业务能力
依托 AI 大脑统筹意图,底层融合 SQL 统计算力、Python 流程编排与 Chart 渲染能力,专为数据分析师解决以下高频、繁重的核心业务任务:
- 数据清洗与规范治理
:自动排查脏数据,极速完成去重补空、渠道/品类别名对齐与敏感隐私脱敏。 - 多表关联与智能对账
:彻底取代脆弱的 VLOOKUP,秒级实现跨系统多表拼接,自动拆解差异对账清单。 - 高阶指标与多维分析
:周期同环比、滑动累计、毛利贡献与 TOP 排名,千万行大表秒级出数、零公式嵌套。 - 自动化流水线编排
:为数据处理赋予分支判断与批量循环能力,复杂任务一键沉淀、换表即可重跑。 - 图表看板与报告交付
:一键生成折线图、柱状图、分布图等交互式可视化看板,核心业务结论开箱即用。 - 数据源:支持CSV/XLSX, MySQL数据库。
过程可信与安全护航:对账、流转与实时回滚
为了确保企业生产环境下的数据准确与容错安全,DTBot 提供了全链路的确定性保障:
- 结果对账保障数据准确
:计算完成后自动进行口径核对与结果对账,严密核验每步处理前后的数据行数与指标一致性,彻底杜绝数据失真与遗漏。 - 执行过程日志(流转全透明)
:实时输出结构化执行日志,直观展示每一步的数据流转过程(输入行数 → 处理规则 → 输出行数),让每一张中间表的流转与加工完全透明、有据可查。 - 操作日志与实时回滚表
:完整记录工作空间的所有操作日志,支持随时一键将表格秒级回滚到任意历史状态,彻底消除改错数据的后顾之忧。